¿Tienes una tabla de datos y no sabes qué prueba estadística utilizar?
Una t de Student, una correlación, una regresión… Hay tantos nombres que es fácil empezar buscando el botón antes de tener clara la pregunta.
Yo te propongo hacerlo al revés. Primero escribe qué quieres saber. Después ya elegiremos la técnica.
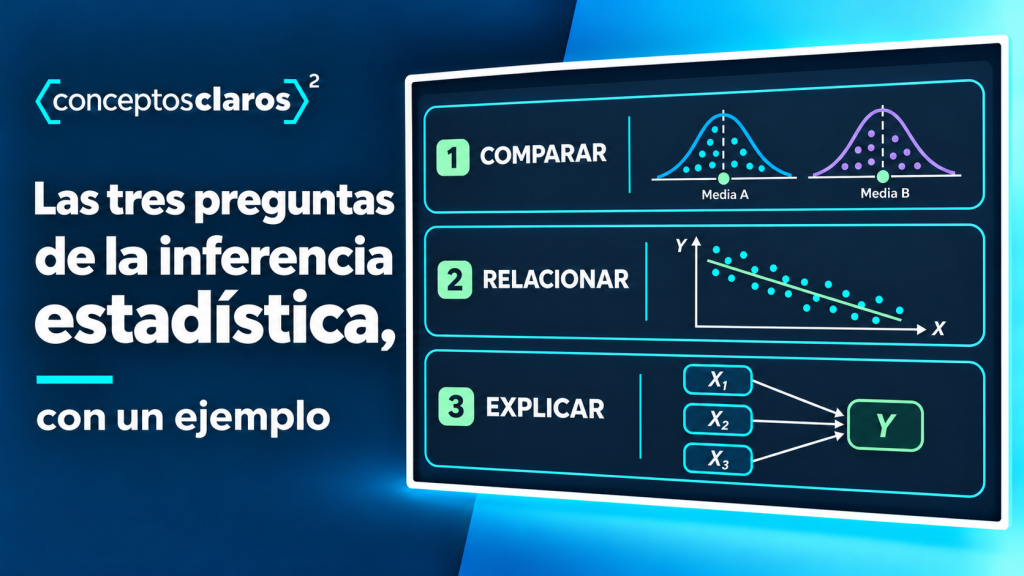
Para ayudarte a dar ese primer paso, vamos a trabajar las tres preguntas de la inferencia estadística: comparar, relacionar y explicar. Usaremos el mismo ejemplo de principio a fin. Así verás que una sola tabla puede responder preguntas distintas y que cada respuesta tiene su interpretación.
Las tres preguntas de la inferencia, explicadas en vídeo
En este fragmento de clase te acompaño por el mismo ejemplo: comparar grupos, relacionar dos variables y estudiar varias a la vez. Puedes ver la explicación en menos de cinco minutos y después probar los gráficos del artículo.
Explora el ejemplo completo: compara, relaciona y explica
Aquí tienes todo el ejemplo interactivo. Puedes ocultar las medias o las cajas, mover la edad y cambiar las variables del modelo. Más abajo encontrarás la explicación paso a paso.
Prueba los controles: observa qué cambia y escribe cómo lo interpretarías. El modelo logístico es una demostración docente, no una herramienta de diagnóstico.
Un ejemplo para entender las tres preguntas de la inferencia
Imagínate una hoja de Excel en la que cada fila representa a un paciente. En las columnas tenemos su edad, la frecuencia cardiaca máxima alcanzada durante una prueba de esfuerzo y si consta o no enfermedad cardiaca, entre otras variables.
Trabajaremos con los 303 registros incluidos en el material Heart Data de esta explicación. Se utiliza como ejemplo docente de la familia de datos Heart Disease de Cleveland, documentada en el repositorio de UCI. Es un conjunto histórico: nos sirve para aprender estadística, no para diagnosticar a una persona ni para describir a todos los pacientes actuales.
Antes de calcular, hay un detalle importante: en este material, 0 significa sin enfermedad y 1 significa con enfermedad. Comprueba siempre el diccionario de tu archivo. Otras versiones pueden utilizar códigos diferentes, aunque el nombre del conjunto se parezca.
La frecuencia cardiaca máxima está medida en latidos por minuto, o lpm. No es el pulso en reposo. Y la edad está medida en años.
Con estas mismas columnas podemos plantear lo siguiente:
| Qué quiero hacer | Mi pregunta | Una técnica que podemos valorar |
|---|---|---|
| Comparar | ¿Difiere la frecuencia cardiaca máxima entre pacientes con y sin enfermedad? | Comparación de medias: t de Welch. |
| Relacionar | ¿Qué relación hay entre la edad y la frecuencia cardiaca máxima? | Diagrama de dispersión y correlación de Pearson. |
| Explicar | ¿Cómo se asocia la presencia de enfermedad con la edad, el sexo, el tipo de dolor torácico y la frecuencia máxima, consideradas conjuntamente? | Regresión logística. |
Esto es un mapa para orientarte, no una lista de recetas ni una clasificación de toda la estadística. También importan cómo has recogido los datos, qué representa cada fila, el tipo de variables y los supuestos del análisis.
1. Comparar: ¿son diferentes los dos grupos?
Empecemos por una pregunta concreta: ¿la frecuencia cardiaca máxima es distinta entre pacientes con y sin enfermedad?
Aquí tenemos una variable numérica que queremos comparar —la frecuencia máxima— y una variable que forma los grupos —el diagnóstico—. Cada paciente pertenece a un solo grupo.
Primero dibujamos los datos. Después miramos las medias, la dispersión y el número de pacientes. No empieces por el p-valor: antes necesitas saber qué estás comparando.
| Grupo | Pacientes | Media | Desviación estándar |
|---|---|---|---|
| Sin enfermedad | 165 | 158,5 lpm | 19,2 lpm |
| Con enfermedad | 138 | 139,1 lpm | 22,6 lpm |
La diferencia de medias es de 19,4 lpm: 158,5 − 139,1, utilizando las medias redondeadas. En esta muestra, el grupo sin enfermedad alcanza una frecuencia máxima media mayor.
Si planteamos una comparación de medias entre dos grupos independientes, la t de Welch permite hacerlo sin suponer que sus varianzas sean iguales. Hay que revisar igualmente la independencia de las observaciones, los valores extremos y si el análisis encaja con el diseño del estudio.
En el material, el contraste da t ≈ 7,95 y p < 0,001. El intervalo de confianza del 95 % para la diferencia de medias es, aproximadamente, de 14,6 a 24,2 lpm.
¿Cómo lo contaría con palabras?
«En los datos analizados, los pacientes sin enfermedad presentan una frecuencia cardiaca máxima media unos 19,4 lpm mayor que los pacientes con enfermedad. La estimación de esa diferencia tiene un intervalo de confianza del 95 % de 14,6 a 24,2 lpm».
Fíjate en lo que estamos diciendo: hablamos de medias de grupos. Los valores individuales se solapan. No estamos diciendo que cualquier paciente sin enfermedad vaya a superar a cualquier paciente con enfermedad, ni que alcanzar más pulsaciones evite la enfermedad.
El p-valor tampoco mide la importancia clínica ni la probabilidad de que nuestra conclusión sea correcta. Si necesitas repasarlo, aquí te explico qué es el p-valor y cómo interpretarlo.
2. Relacionar: ¿qué ocurre con la frecuencia máxima a medida que aumenta la edad?
Ahora dejamos de separar por diagnóstico y utilizamos dos variables numéricas: edad y frecuencia cardiaca máxima.
La pregunta cambia: ¿tienden los pacientes de mayor edad a alcanzar una frecuencia máxima menor?
El gráfico adecuado para empezar es un diagrama de dispersión. Ponemos la edad en el eje horizontal y la frecuencia máxima en el vertical. Cada punto representa un paciente; si dos pacientes comparten ambos valores, sus puntos se superponen.
En estos datos, la correlación de Pearson es r ≈ −0,40, con un intervalo de confianza del 95 % aproximado entre −0,49 y −0,30.
El signo negativo indica la dirección: las edades mayores tienden a acompañarse de frecuencias máximas menores. La relación está lejos de ser perfecta. A una misma edad encontramos frecuencias bastante diferentes.
Si ajustamos una recta sencilla, obtenemos aproximadamente:
Dentro del rango observado, diez años más de edad se asocian con unos diez lpm menos en el valor medio estimado por esta recta.
¿Significa eso que cada paciente perderá diez pulsaciones al cumplir diez años más?
No podemos afirmarlo con esta tabla. Estamos comparando personas de edades distintas, no siguiendo a las mismas personas durante diez años. Tampoco hemos aislado aquí otras características que puedan intervenir.
Por eso quiero que recuerdes algo: una correlación describe una asociación; por sí sola no demuestra una causa.
Y otra precaución. Pearson resume una relación lineal. Una correlación cercana a cero no descarta una relación con forma de curva. Hay que mirar el gráfico. Spearman puede ayudarnos a estudiar relaciones monótonas mediante rangos, pero tampoco detecta cualquier relación no lineal.
3. Explicar: ¿qué ocurre cuando estudiamos varias variables a la vez?
Hasta aquí hemos mirado una comparación entre dos grupos y una relación entre dos variables.
Pero los pacientes se diferencian en más cosas que la edad. Podemos preguntarnos: ¿cómo se asocia cada característica con la presencia de enfermedad si tenemos en cuenta también las otras?
Ahora definimos una variable resultado, que solemos llamar Y: presencia o ausencia de enfermedad. Y varias variables que utilizamos para estudiarla, las X: edad, sexo, tipo de dolor torácico y frecuencia cardiaca máxima.
La flecha representa la estructura del modelo estadístico, no una demostración de causalidad.
Como Y tiene dos categorías, podemos plantear una regresión logística. Si Y fuera una medida numérica, como una puntuación, valoraríamos otro tipo de modelo, según la pregunta y sus supuestos.
Qué significa «teniendo en cuenta las otras variables»
En el modelo del material, la odds ratio de la frecuencia máxima es de aproximadamente 0,73 por cada diez lpm adicionales. Se calcula a partir del coeficiente del modelo: exp(−0,03088 × 10).
Esto indica que, para perfiles con la misma edad, sexo y categoría de dolor torácico según el modelo, diez lpm más se asocian con unas odds de enfermedad multiplicadas por 0,73. Son aproximadamente un 27 % menores.
Tranquilo, aclaremos esa palabra. Las odds son la probabilidad de que ocurra algo dividida entre la probabilidad de que no ocurra: p / (1 − p).
Reducir las odds un 27 % no significa reducir la probabilidad 27 puntos porcentuales. Para ver la diferencia, imagina una probabilidad inicial del 20 %. Sus odds son 0,20 / 0,80 = 0,25. Si las multiplicamos por 0,73, quedan en 0,1825. Al volver a probabilidad, obtenemos 0,1825 / 1,1825 ≈ 15,4 %. Estas cifras son un ejemplo aritmético, no una predicción para un paciente del conjunto.
Si quieres profundizar sin perderte en las fórmulas, tienes esta explicación de qué es una regresión logística y cómo interpretarla.
Explicar, predecir y demostrar una causa son objetivos diferentes
Con «explicar» nos referimos aquí a estudiar asociaciones ajustadas dentro de un modelo. Incluir varias X no elimina automáticamente los sesgos ni las variables que nos faltan. Para hablar de causas hacen falta un diseño y unos supuestos que lo permitan.
Tampoco basta con que el modelo se ajuste bien a los mismos datos con los que lo hemos construido. Para valorar predicciones en pacientes nuevos necesitamos una evaluación con datos no utilizados en el ajuste y comprobar, entre otras cosas, su discriminación y calibración. Este ejemplo docente no constituye una herramienta clínica validada.
Qué aporta la inferencia más allá del gráfico
El gráfico nos ayuda a ver lo que ocurre en la muestra. La inferencia añade herramientas para estimar diferencias o asociaciones y expresar su incertidumbre bajo unos supuestos.
Por eso no me quedaría solo con «hay diferencias» o «la correlación es significativa». Quiero saber cuánto cambia el resultado, con qué precisión lo estimamos y hasta dónde podemos generalizar.
Un intervalo de confianza no corrige una muestra sesgada. Tener 303 registros tampoco convierte esos datos históricos en una representación de toda la población actual. Hay que conectar cada conclusión con la forma en que se obtuvieron los datos.
Cómo utilizar la IA para elegir el análisis sin hacerlo a ciegas
La IA puede ayudarte a ordenar las preguntas, preparar cálculos y revisar una interpretación. Para ello necesita contexto. Si solo le dices «hazme la estadística de este Excel», le estás dejando decidir demasiadas cosas.
Yo empezaría con una instrucción como esta, utilizando datos que puedas compartir con la herramienta:
Cada fila de mi tabla representa [unidad de observación]. Quiero responder [pregunta concreta]. Estas son mis variables y su significado: [diccionario]. Antes de calcular, dime si estoy comparando grupos, relacionando variables o estudiando varias conjuntamente. Identifica la variable resultado y las explicativas cuando corresponda. Pregúntame por el diseño, si hay medidas repetidas y cómo se seleccionaron los casos. Propón un gráfico y un análisis con sus supuestos. Si falta información, indícalo. No inventes resultados. Después muestra el tamaño de la muestra utilizado, la estimación y su incertidumbre, y separa lo que podemos concluir de lo que no.
Después comprueba una parte que puedas seguir. Por ejemplo, los tamaños de los dos grupos y sus medias. Revisa que no haya cambiado el significado de 0 y 1 y que explique cuántos registros ha excluido por valores ausentes.
Y pídele que reformule la conclusión sin utilizar «causa» cuando el análisis solo permite hablar de asociación. Esta revisión vale tanto si trabajas en Excel como si utilizas R o Python.
Si necesitas ordenar todo el proceso antes de elegir la técnica, puedes apoyarte en el método para plantear un proyecto de análisis de datos.
Ahora te toca a ti: tres preguntas para tus propios datos
Abre una tabla que conozcas y escribe estas tres frases, adaptándolas a tu caso:
- Quiero comparar… una medida entre unos grupos. Por ejemplo, una puntuación entre dos grupos independientes.
- Quiero relacionar… dos variables. Por ejemplo, horas de estudio y puntuación.
- Quiero estudiar conjuntamente… cómo se asocia una variable resultado con varias características. Por ejemplo, la puntuación con horas de estudio, asistencia y conocimientos previos.
Debajo de cada frase, anota qué representa una fila, qué variables utilizarías y qué gráfico mirarías primero. Si hay medidas antes y después de las mismas personas, escríbelo: el análisis debe tener en cuenta esa dependencia.
No hace falta calcular todavía. Si consigues formular bien esas preguntas, ya habrás dado un paso importante para elegir tu análisis con criterio 🙂
¿Quieres aplicar esta lógica a los datos de tu investigación?
En la formación de Estadística en Excel con IA trabajamos desde la preparación de la tabla hasta la elección y la interpretación de los análisis, con casos prácticos como Heart Data. Puedes consultar el programa y valorar qué parte necesitas para tu proyecto.
Ver la formación de Excel y Estadística con IAEspero que el ejemplo te ayude a mirar tu próxima tabla con más claridad. Empieza por escribir lo que quieres saber. El nombre de la técnica vendrá después.
Un abrazo,
Jordi
Sobre el ejemplo: artículo elaborado a partir del material docente «Las tres preguntas de la inferencia · Heart Data». Las medias, tamaños de grupo, correlación y recta se han recalculado sobre sus 303 registros; el contraste y el intervalo de la diferencia corresponden al análisis presentado en ese material. La odds ratio procede de sus coeficientes logísticos; no se ha vuelto a ajustar ese modelo con las variables completas. Consulta la documentación de Heart Disease en UCI para el origen y las variables, y la documentación de la t de Welch para los supuestos del contraste. Los códigos de una versión deben comprobarse en su propio diccionario.