¿Tienes delante un árbol de decisión y no sabes por dónde empezar a leerlo?
Ves cajas, flechas, preguntas y unos números al final. Quizá se lo has pedido a una IA y el dibujo tiene buena pinta. Pero ahora necesitas explicar qué significa.
Vamos a verlo con un ejemplo de vivienda. Primero recorreremos una rama. Después te enseñaré qué busca el árbol cuando decide dónde dividir los datos y qué conviene comprobar antes de utilizar su predicción.
La idea que quiero que te lleves: cada camino del árbol reúne unas condiciones. Al llegar al final, encuentras la predicción para los casos que cumplen todas esas condiciones.
Cómo interpretar un árbol de decisión: te lo explico en vídeo
En este fragmento de una clase de AD + IA utilizo un ejemplo de precio de vivienda por metro cuadrado. Verás cómo se encadenan las preguntas y cómo cambia el error al mover un umbral.
Qué hace un árbol de decisión con tus datos
Imagínate una tabla de viviendas. Cada fila es una vivienda y tienes información sobre su provincia, superficie, número de baños y precio por metro cuadrado.
Queremos utilizar algunas de esas características para predecir el precio por m². El árbol va haciendo preguntas y separando las filas según las respuestas.
Una pregunta puede ser si la superficie supera cierto valor. Los casos que cumplen la condición van por una rama y los demás, por otra. Después, cada grupo puede volver a dividirse.
En este ejemplo la variable que queremos predecir es numérica. Por eso hablamos de un árbol de regresión. Si quisiéramos predecir una categoría, estaríamos ante un problema de clasificación.
Cómo leer una rama del árbol paso a paso
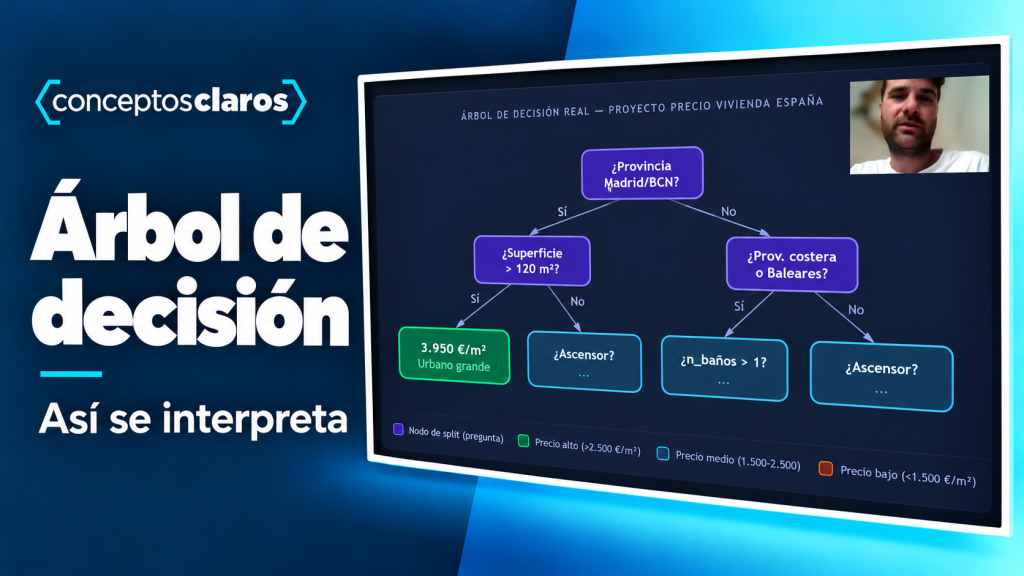
Empieza por la pregunta de arriba. Mira qué condición cumple tu caso y sigue la flecha correspondiente. Repite el proceso hasta llegar a una hoja, que es un nodo sin nuevas divisiones.
Fíjate en la rama del ejemplo que pasa por el grupo de provincias Madrid/Barcelona y por una superficie superior a 120 m². La hoja muestra 3.950 €/m².
Provincia dentro del grupo indicado
↓
Superficie superior a 120 m²
↓
Predicción de la hoja: 3.950 €/m²
Para interpretar esa hoja necesitas las dos condiciones. No puedes saltarte la provincia y decir que todas las viviendas de más de 120 m² tienen ese precio.
Y cuidado con las unidades: estamos hablando de euros por metro cuadrado, no del precio total de la vivienda.
En un árbol de regresión ajustado con error cuadrático y sin ponderaciones, la predicción de cada hoja es la media de los valores de entrenamiento que han llegado allí. Los importes de la demostración sirven para entender el mecanismo; no constituyen una tasación ni una estimación actual del mercado.
Cómo decide el árbol dónde dividir
La pregunta que suele aparecer aquí es: «¿Tengo que decirle yo qué variable debe ir primero?».
Durante el entrenamiento, el algoritmo compara divisiones candidatas según las variables, los umbrales y las restricciones que hayamos definido. En cada nodo busca una división que reduzca el error.
Podría probar distintos cortes de superficie y comprobar cómo quedan los precios dentro de los grupos resultantes. En un árbol de regresión con error cuadrático interesa que los valores de cada grupo se parezcan más entre sí.
Un buen corte no tiene por qué dejar la mitad de las viviendas a cada lado. Lo que estamos evaluando es cuánto mejora la predicción al separar los casos.
La elección se hace en cada nodo con los casos que llegan a él. Que una variable aparezca arriba no demuestra que cause el precio ni equivale, por sí solo, a medir su importancia global.
Un ejemplo pequeño para entender la reducción del error
Vamos a apartarnos un momento del vídeo para hacer unas cuentas sencillas. Estos cuatro valores son ficticios, elegidos para comprobar el cálculo.
| Vivienda | Superficie | Precio por m² |
|---|---|---|
| A | 60 m² | 1.000 € |
| B | 80 m² | 1.200 € |
| C | 140 m² | 3.000 € |
| D | 160 m² | 3.200 € |
Si utilizamos una única media para las cuatro viviendas, predecimos 2.100 €/m² para todas. El error cuadrático medio es:
(1.100² + 900² + 900² + 1.100²) / 4 = 1.010.000.
Ahora dividimos por una superficie de 120 m². A y B quedan juntas, con una media de 1.100 €/m². C y D forman el otro grupo, con una media de 3.100 €/m².
Cada vivienda se aparta 100 €/m² de la media de su grupo. El nuevo error cuadrático medio es 10.000. Lo expresamos en unidades al cuadrado; si calculamos su raíz, obtenemos 100 €/m².
¿Ves por qué ese corte ayuda? Dentro de cada grupo los precios se parecen más. Aquí salen dos grupos del mismo tamaño, pero esa coincidencia no es el criterio que estamos optimizando.
Estas cuentas solo explican el ajuste sobre esos cuatro datos. Para saber si el árbol funciona con viviendas nuevas necesitamos evaluarlo con datos que no haya usado para aprender.
Qué pedirle a la IA cuando te genera un árbol de decisión
La IA puede ayudarte a preparar el código, dibujar el árbol y recorrer sus reglas. Para revisar el resultado, pídele que te enseñe qué ha hecho con tus datos.
Quiero predecir el precio por m² de una vivienda. Antes de entrenar un árbol, confirma qué representa cada fila, qué variables usarás y cuál es la variable objetivo. Explica cómo separarás entrenamiento y evaluación evitando que información del resultado entre como predictor. Dibuja un árbol sencillo, recorre una rama con un caso concreto y comprueba que la explicación coincide con sus condiciones. Indica cuántos casos llegan a la hoja, cómo se calcula su predicción y cómo cambia el error al evaluar datos no usados para entrenar. Si falta información, indícalo.
Si aparecen provincias codificadas como números, pregunta qué significa esa codificación y cómo la utiliza el modelo. El número asignado a una categoría no debería interpretarse automáticamente como una cantidad.
Revisa también si el texto de la IA coincide con el dibujo. Es fácil que describa solo la última condición y olvide las anteriores. Escoge una fila y recorre tú mismo su camino.
Si todavía estás decidiendo qué necesitas analizar, empieza por el método para plantear un proyecto de análisis de datos con IA. Elegir el modelo viene después de entender la pregunta.
Dos dudas que conviene aclarar
¿Un árbol más grande predice mejor?
Puede ajustarse mejor a los datos con los que aprende y funcionar peor con casos nuevos. Es el sobreajuste. La profundidad, el tamaño mínimo de las hojas y la poda ayudan a controlar la complejidad; hay que elegirlos mediante validación, no solo mirando el error de entrenamiento.
¿Tengo que estandarizar como en K-means?
Los árboles que dividen por umbrales de una variable no dependen de distancias como K-means. Un cambio lineal de escala conserva el orden de una variable y, en términos matemáticos, las particiones disponibles. Eso no elimina la necesidad de revisar errores, valores ausentes y categorías. Aquí puedes comparar el razonamiento con el ejemplo de por qué estandarizamos antes de K-means.
Ahora te toca a ti: explica una predicción sin mirar la respuesta de la IA
Escoge un caso de tu tabla y anota todas las condiciones que cumple desde la raíz hasta la hoja. Después escribe una frase que incluya ese recorrido, la predicción y sus unidades.
Comprueba cuántos casos apoyan esa hoja y pregunta cómo se ha evaluado el modelo con datos nuevos. Con ese pequeño ejercicio empezarás a distinguir entre entender un dibujo y poder defender un resultado.
Cuando ya tengas el análisis revisado, puedes pensar en cómo presentarlo. En el artículo sobre dashboards con IA, HTML y Python te explico dos maneras de convertir los resultados en una entrega que puedas compartir.
¿Tienes datos, pero todavía no tienes claro por dónde empezar?
He preparado el Kit de Arranque de Análisis de Datos + IA para ayudarte a ordenar el problema, las preguntas y los datos que necesitas antes de elegir una técnica.
Acceder al Kit gratuitoEspero que este ejemplo te ayude a mirar el próximo árbol con otros ojos. Empieza por una rama y comprueba cada paso 🙂
Un abrazo,
Jordi
Para profundizar: documentación de árboles de regresión de scikit-learn. El vídeo muestra una explicación de clase; el ejemplo de cuatro viviendas del artículo es ficticio y adicional.