¿Te han recomendado estandarizar datos antes de K-means y no tienes claro para qué sirve?
Quizá ya has elegido las variables, has calculado los grupos y tienes un gráfico donde todo parece bastante claro.
Pero antes de interpretar esos grupos hay un detalle que quiero explicarte: la escala de las variables puede cambiar el resultado.
Por eso conviene entender por qué estandarizar datos antes de K-means. Vamos a verlo con un ejemplo de municipios y, después, con unos números que puedes comprobar tú mismo.
Y si estás utilizando una IA para analizar tu tabla, también te enseñaré qué puedes pedirle para entender este paso y comprobar el resultado.
¿Empezamos?
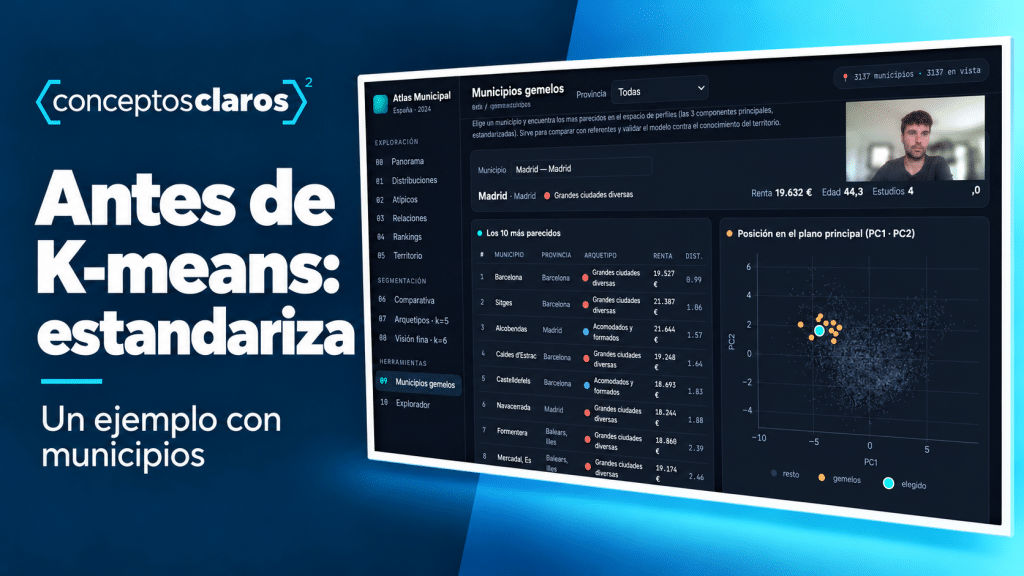
Un ejemplo con municipios: te lo explico en vídeo
Imagínate que quieres encontrar municipios parecidos según su población, la renta de sus habitantes y su edad.
Son tres características interesantes. Pero cada una se mide de una forma diferente. En este vídeo te muestro por qué eso importa cuando queremos calcular qué municipios se parecen.
¿Por qué estandarizar datos antes de K-means?
Primero de todo, piensa qué queremos conseguir con el clustering.
Queremos crear grupos de observaciones que tengan características similares. Pueden ser municipios, clientes, vinos o pacientes. Si esta idea todavía te resulta nueva, aquí te explico qué es el clustering con un ejemplo práctico.
En K-means, esa similitud se calcula a partir de las distancias entre los datos y los centros de los grupos.
Y aquí aparece el problema.
En el ejemplo de los municipios estamos mezclando número de habitantes, euros y años. Las diferencias de población pueden ser de miles de habitantes. Las de edad, de unos pocos años.
Si calculamos la distancia directamente con esos números, una variable puede pesar muchísimo más que otra.
¿Porque sea más importante para lo que queremos estudiar?
No necesariamente. También puede ser por la escala en la que la hemos medido.
Fíjate en esto: expresar la población en habitantes o en miles de habitantes no cambia el municipio. Pero sí cambia los números que entran en el cálculo de la distancia.
Esta es la idea: queremos decidir qué características nos interesan, sin dejar que sus unidades decidan por nosotros.
¿Qué significa estandarizar los datos?
La estandarización más habitual consiste en hacer dos operaciones con cada variable:
- Restarle su media.
- Dividir el resultado por su desviación estándar.
Escrito en una fórmula queda así:
Valor estandarizado = (valor − media) / desviación estándar
Tranquilo. Vamos a darle sentido.
Supongamos que, en una tabla de municipios, la edad media de los habitantes es de 40 años y la desviación estándar es de 5. Son números inventados para entender el cálculo.
Para un municipio con una edad de 45 años, el valor estandarizado sería:
(45 − 40) / 5 = 1.
¿Qué significa ese 1?
Que ese municipio está una desviación estándar por encima de la media. Si tuviera 35 años, su valor sería −1. Y si tuviera 40, sería 0.
Hacemos lo mismo con la renta y con la población. Así expresamos cada variable respecto a su propia variabilidad, sin conservar sus unidades originales.
En los datos con los que calculamos la transformación, las variables no constantes quedan con media 0 y desviación estándar 1, usando la misma forma de calcular la desviación.
Eso no convierte todas las variables en igual de importantes para tu proyecto. Nos permite compararlas en una escala común. La elección de las variables sigue siendo tuya.
Un ejemplo para ver cuánto pesa cada variable
Vamos a cambiar un momento de ejemplo para hacer las cuentas fácilmente.
Imagínate que quieres agrupar clientes según cuánto gastan al año, cuántas compras hacen y cuánto tiempo llevan contigo.
Entre dos clientes hay estas diferencias: 2.000 euros de gasto, dos compras y un año de antigüedad.
Al calcular la distancia euclídea al cuadrado, cada diferencia se eleva al cuadrado y después se suma:
2.000² + 2² + 1² = 4.000.005.
Fíjate en la aportación del gasto: 4.000.000. Las otras dos variables apenas cuentan en esa suma.
Ahora supongamos que las desviaciones estándar de nuestra tabla son 2.000 euros, dos compras y cuatro años. De nuevo, son cifras elegidas para explicar el ejemplo.
Después de estandarizar, las diferencias entre esos mismos clientes quedan así:
| Variable | Diferencia original | Diferencia estandarizada | Aportación a la distancia al cuadrado |
|---|---|---|---|
| Gasto anual | 2.000 € | 2.000 / 2.000 = 1 | 1 |
| Compras anuales | 2 | 2 / 2 = 1 | 1 |
| Antigüedad | 1 año | 1 / 4 = 0,25 | 0,0625 |
La nueva suma es 1 + 1 + 0,0625 = 2,0625.
¿Ves qué ha cambiado?
El gasto ya no se lleva casi todo el peso de la comparación. Gasto y compras aportan lo mismo en este caso. La antigüedad aporta menos porque un año es una diferencia pequeña respecto a la variabilidad de esa variable.
Que la distancia sea menor no significa que el modelo sea mejor. Hemos cambiado la escala. Lo que nos interesa es entender cómo contribuye cada variable al cálculo.
Cómo estandarizar datos antes de K-means paso a paso
Antes de ejecutar el algoritmo, dedica un rato a mirar la tabla.
¿Qué representa cada fila? ¿Qué variables has elegido? ¿En qué unidades están? Un código de cliente, aunque sea un número, no es una medida de comportamiento.
Después dibuja tus variables. Un histograma o un boxplot te ayudará a ver su distribución y posibles valores extremos. Si necesitas situarte, puedes empezar con estos gráficos para explorar tus datos.
Revisa también los valores ausentes y las variables constantes. Si todos los registros tienen el mismo valor en una variable, su desviación estándar es cero y no te ayuda a separar grupos.
Cuando tengas claro qué vas a utilizar, calcula la media y la desviación estándar de cada variable y aplica la transformación. Guarda esos valores: si más adelante llegan casos nuevos, tendrás que utilizar la misma transformación para compararlos con los grupos originales.
Si separas datos para entrenar y evaluar un modelo, calcula la transformación con los de entrenamiento y aplícala después a los de evaluación.
Y ahora sí: calcula los clústeres y comprueba qué has obtenido. Prueba varias inicializaciones de K-means y revisa si los grupos se mantienen razonablemente estables.
Para interpretarlos, vuelve a las unidades originales. Decir que un grupo gasta una determinada cantidad de euros resulta más fácil de entender que hablar solo de valores estandarizados.
Estandarizar datos con IA: qué pedirle antes de K-means
Quizá estás trabajando tu tabla con una IA y le has pedido que encuentre grupos.
Antes de aceptar lo que te devuelve, pídele que te explique cómo ha preparado las variables. Si te dice que ha estandarizado los datos, que te enseñe las medias, las desviaciones y un cálculo que puedas revisar.
Puedes empezar con algo así:
Quiero agrupar municipios según población, renta y edad. Antes de aplicar K-means, revisa las unidades y la variabilidad de cada variable, los valores ausentes y los extremos. Explica qué escalado propones y por qué. Si estandarizas, muestra las medias y desviaciones utilizadas. Escoge dos registros y calcula cuánto aporta cada variable a la distancia al cuadrado antes y después de estandarizar. Identifica los registros y enséñame las cuentas.
¿Por qué pedirle dos registros?
Porque así puedes seguir el cálculo. Si solo te devuelve un gráfico bonito, cuesta más saber qué ha hecho con tus datos.
Después puedes pedirle una tabla con las características de cada grupo en las unidades originales y una explicación sencilla de las diferencias. Revisa que lo que cuenta coincida con los números.
Y una pregunta más que me parece útil: «¿Qué conclusiones no puedo sacar de estos grupos?» Por ejemplo, agrupar municipios parecidos no demuestra qué ha causado sus diferencias.
Si quieres situar este trabajo dentro del proyecto, en el método de análisis de datos con IA te explico el recorrido completo.
Dos dudas que conviene aclarar
¿Hay que estandarizar siempre?
No lo tomaría como una receta automática. Si mezclas variables con unidades o variabilidades muy diferentes, es un paso que conviene considerar antes de aplicar K-means.
Pero puede que quieras dar más peso a una característica porque tu objetivo lo requiere. En ese caso, decide ese peso y comprueba qué efecto tiene en los grupos.
Además, la media y la desviación estándar son sensibles a los valores extremos. Si los hay, revisa primero si son errores o casos reales. Puede que necesites otra transformación o un escalado robusto.
¿Estandarizar hace que los datos sigan una distribución normal?
No. Cambia el centro y la escala de la variable, pero no elimina su asimetría.
Tampoco soluciona variables redundantes ni convierte cualquier tabla en adecuada para K-means. Si incluyes varias medidas casi iguales, estarás dando más peso a ese mismo aspecto. Y si tus variables son categóricas o tus grupos tienen formas muy distintas, tendrás que revisar qué técnica encaja mejor.
Ahora te toca a ti: prueba con dos registros
Te propongo un ejercicio sencillo.
Escoge dos registros de tu tabla y tres variables numéricas que quieras utilizar para agruparlos. Anota sus unidades y calcula cuánto aporta cada diferencia a la distancia al cuadrado.
Después estandariza las variables y repite la comparación.
¿Qué variable pesaba más antes? ¿Qué ocurre después? ¿Tiene sentido para lo que quieres estudiar?
Con este pequeño ejercicio puedes entender mucho mejor qué está haciendo el algoritmo. Es una buena forma de aprender trabajando con tus propios datos 🙂
¿Tienes datos, pero no sabes qué variables elegir o cómo interpretar tus grupos?
Cuéntame qué quieres estudiar y dónde te has quedado bloqueado. Así podré orientarte sobre el siguiente paso.
Espero que el ejemplo te haya ayudado a entender por qué estandarizar datos antes de K-means puede cambiar la agrupación que obtienes.
Un abrazo,
Jordi
Si quieres profundizar en la parte técnica, aquí tienes la documentación de StandardScaler y la explicación de K-means en scikit-learn.